AI-модели всё активнее используются в повседневной разработке. Они пишут контроллеры, создают интерфейсы, работают с базой данных, исправляют ошибки и могут практически самостоятельно реализовать небольшую задачу от начала до конца.
Но вместе с этим возникает простой вопрос: насколько вообще оправдано использование дорогой флагманской модели для обычной веб-разработки?
Если задача типовая, например создать CRUD для пользователей, будет ли дорогая модель действительно заметно лучше более дешёвых альтернатив?
Я решил проверить это на практике.
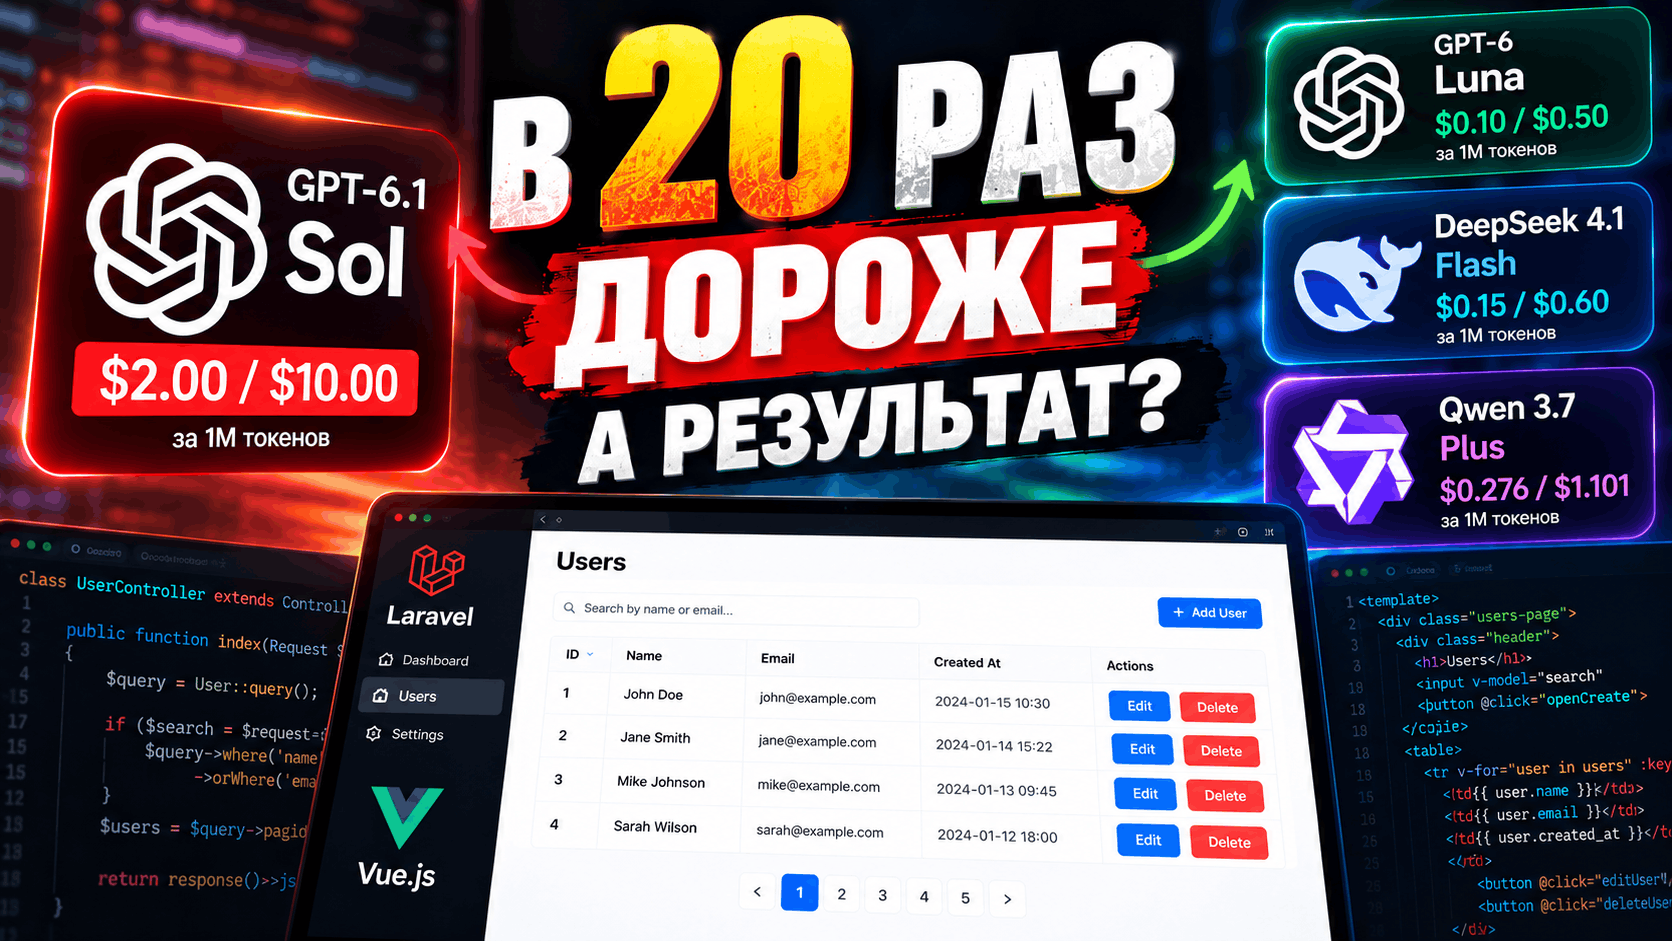
Для эксперимента я взял четыре AI-модели:
- GPT-6.1 Sol
- GPT-6 Luna
- DeepSeek 4.1 Flash
- Qwen 3.7 Plus
Все модели получили одинаковый проект, одинаковое задание и одинаковые стартовые условия.
Полный эксперимент и проверку интерфейсов я записал на видео.
Что именно проверялось
Я специально не стал придумывать сложный искусственный benchmark.
Задача максимально обычная для веб-разработчика - реализовать CRUD пользователей.
CRUD - это стандартный набор операций:
- просмотр данных;
- создание;
- редактирование;
- удаление.
Дополнительно модели должны были реализовать:
- поиск пользователей;
- пагинацию;
- серверную валидацию;
- отображение ошибок;
- REST API;
- frontend на Vue.js.
То есть это вполне типовая задача, с которой разработчик может столкнуться в обычном коммерческом проекте.
Одинаковое окружение для всех моделей
Для каждой AI-модели был подготовлен отдельный идентичный проект.
Стек:
- Laravel;
- Vue 3;
- Vite;
- JavaScript;
- SQLite.
У каждого проекта была собственная изолированная база данных SQLite.
Laravel и Vue уже были настроены, миграции выполнены, таблица пользователей существовала.
При этом самого CRUD в проекте заранее не было.
Все модели получили один и тот же промпт.
Никаких дополнительных подсказок во время выполнения задачи я не давал.
Модель должна была самостоятельно:
- разобраться в существующем проекте;
- создать REST API;
- написать backend;
- сделать Vue-интерфейс;
- реализовать CRUD;
- добавить поиск;
- сделать пагинацию;
- реализовать валидацию;
- собрать production frontend;
- проверить собственный результат.
После завершения работы я просто открывал /users и проверял то, что получилось.
Почему сравнивались именно эти модели
Основная идея эксперимента была не в поиске "самой умной модели".
Меня интересовал другой вопрос:
Нужна ли дорогая модель для обычных задач программирования?
GPT-6.1 Sol в этом тесте выступала в роли мощной флагманской модели.
Остальные модели - это варианты, которые потенциально можно использовать для регулярной повседневной разработки.
Настройки reasoning также отличались.
В тесте использовались:
- GPT-6.1 Sol - Medium;
- GPT-6 Luna - Extra High;
- DeepSeek 4.1 Flash - Max;
- Qwen 3.7 Plus - Default.
Логика здесь достаточно простая.
Более дешёвым моделям можно позволить потратить больше вычислений на размышление, если итоговая стоимость всё равно остаётся значительно ниже стоимости флагманской модели.
Насколько отличаются цены AI-моделей
Разница в стоимости между моделями довольно существенная.
На момент проведения эксперимента ориентировочная API-стоимость за 1 млн токенов выглядела примерно так:
Модель Input Output GPT-6.1 Sol $2.00 $10.00 GPT-6 Luna $0.10 $0.50 DeepSeek 4.1 Flash от $0.15 от $0.60 Qwen 3.7 Plus около $0.276 около $1.101 То есть между Sol и Luna разница в цене одного токена достигает примерно 20 раз.
DeepSeek и Qwen также стоят значительно дешевле Sol.
Именно поэтому мне было интересно посмотреть, будет ли разница в результате настолько же заметной.
Что получилось у GPT-6 Luna
Один из интересных моментов теста произошёл уже с Luna.
Модель выполнила задачу, но после завершения оказалось, что frontend нельзя сразу открыть без дополнительной сборки.
Это хороший пример того, почему недостаточно просто смотреть на код, который написал AI.
Для меня в этом эксперименте важно было оценивать результат именно как пользователь:
модель сказала, что закончила - можно ли после этого действительно открыть приложение и пользоваться им?
После сборки интерфейс Luna оказался вполне удачным.
CRUD работал, интерфейс выглядел аккуратно, основные сценарии были реализованы.
При этом речь идёт о модели, которая по стоимости значительно дешевле Sol.
DeepSeek 4.1 Flash для веб-разработки
DeepSeek 4.1 Flash тоже показал интересный результат.
Несмотря на низкую стоимость модели, итоговый интерфейс оказался вполне пригодным для использования.
Модель справилась с основной логикой CRUD, взаимодействием frontend и backend, поиском и другими требованиями задания.
Именно такие результаты делают дешёвые модели особенно интересными для повседневной разработки.
Если задача хорошо сформулирована и достаточно изолирована, далеко не всегда требуется запускать самую дорогую модель.
Qwen 3.7 Plus
Qwen 3.7 Plus участвовал в тесте со стандартными настройками reasoning.
Это тоже важно.
Целью эксперимента было не заставить каждую модель использовать максимально возможный объём вычислений, а проверить более реалистичный сценарий использования.
То есть примерно так, как разработчик мог бы пользоваться моделью каждый день.
Qwen получил тот же Laravel-проект и тот же промпт, что и остальные участники.
После выполнения задачи результат проверялся по тем же сценариям:
- загрузка списка;
- создание пользователя;
- валидация;
- редактирование;
- удаление;
- поиск;
- пагинация.
А что показала GPT-6.1 Sol
Sol была самой дорогой моделью эксперимента и логично выступала в роли своеобразного ориентира.
Но именно здесь возникает главный вопрос всего теста.
Даже если дорогая модель пишет код немного лучше или принимает более удачные решения, насколько эта разница важна в простой типовой задаче?
В данном эксперименте Sol не показала преимущества, сопоставимого с разницей в стоимости.
Это не означает, что Sol хуже или что дорогие модели не нужны.
Скорее наоборот.
Для сложных архитектурных задач, анализа большой кодовой базы, поиска нетривиальных ошибок или работы с большим количеством взаимосвязанных требований более мощная модель может оказаться значительно полезнее.
Но обычный CRUD - совсем другой случай.
Нужна ли дорогая AI-модель для типовой разработки
По результатам этого небольшого эксперимента мой ответ - не всегда.
Для многих повседневных задач вполне можно начать с более дешёвой модели.
Например:
- небольшой CRUD;
- простые API endpoints;
- стандартные формы;
- валидация;
- типовые изменения интерфейса;
- несложные миграции;
- небольшие исправления;
- генерация тестов;
- рефакторинг отдельных компонентов.
Если задача хорошо ограничена и понятно сформулирована, дешёвая модель может дать результат, очень близкий к более дорогой.
А что делать со сложными задачами
Здесь есть ещё один важный момент.
Большую задачу не обязательно целиком отдавать одной дорогой модели.
Во многих случаях её можно декомпозировать.
Например вместо:
"Разработай полностью новую CRM"
можно отдельно поставить задачи:
- спроектировать структуру клиентов;
- создать API клиентов;
- сделать CRUD;
- добавить сделки;
- реализовать права доступа;
- сделать отчёты;
- написать тесты.
Чем меньше и понятнее отдельная задача, тем выше вероятность, что с ней нормально справится более доступная модель.
Это особенно интересно при использовании AI-агентов, когда разработчик остаётся архитектором и ревьюером, а реализацию отдельных задач делегирует моделям.
Что важнее цены модели
Сам по себе прайс за миллион токенов ещё не говорит, сколько будет стоить конкретная задача.
Более дешёвая модель может генерировать больше кода, дольше рассуждать или несколько раз исправлять собственные ошибки.
Поэтому правильнее смотреть сразу на несколько факторов:
- качество результата;
- количество ошибок;
- самостоятельность модели;
- время выполнения;
- количество потраченных токенов;
- стоимость выполнения конкретной задачи.
И только после этого сравнивать модели между собой.
Итог
Эксперимент не претендует на полноценный benchmark AI-моделей.
Это всего один запуск и одна вполне конкретная задача.
Но именно поэтому он мне и интересен.
В реальной работе разработчик тоже редко решает академические benchmark-задачи.
Нам нужно добавить форму, сделать API, исправить таблицу, реализовать поиск, добавить новую сущность или быстро собрать небольшой функционал.
И на таких задачах разница между дорогой и дешёвой моделью может оказаться значительно меньше, чем разница в их стоимости.
Главный вывод этого теста:
для типовой веб-разработки переплачивать за флагманскую AI-модель нужно далеко не всегда.
Более дешёвые модели вроде Luna, DeepSeek или Qwen уже способны выполнять довольно большой объём обычной разработки.
А дорогие модели имеет смысл подключать там, где задача действительно требует их возможностей.
Полную проверку четырёх моделей, интерфейсы, ошибки и результаты можно посмотреть в видео.
https://rutube.ru/video/private/5ec3be9f624ec05dba97d3d1165793f9/?p=CT3j2qrzyoiDtF1nFwHb5w
Евгений Носенко
Проектирует и разрабатывает системы автоматизации, CRM, интеграции и внутренние сервисы для бизнеса.
Хотите такой же результат?
Бесплатно посчитаем ваш проект и покажем, где автоматизация даст максимальный эффект.
Обсудить проект →
Комментарии · 0